DACA-GRPO: Denoising-Aware Credit Assignment for Reinforcement Learning in Diffusion Language Models
NeurIPS 2026 — Conference on Neural Information Processing Systems, 2026
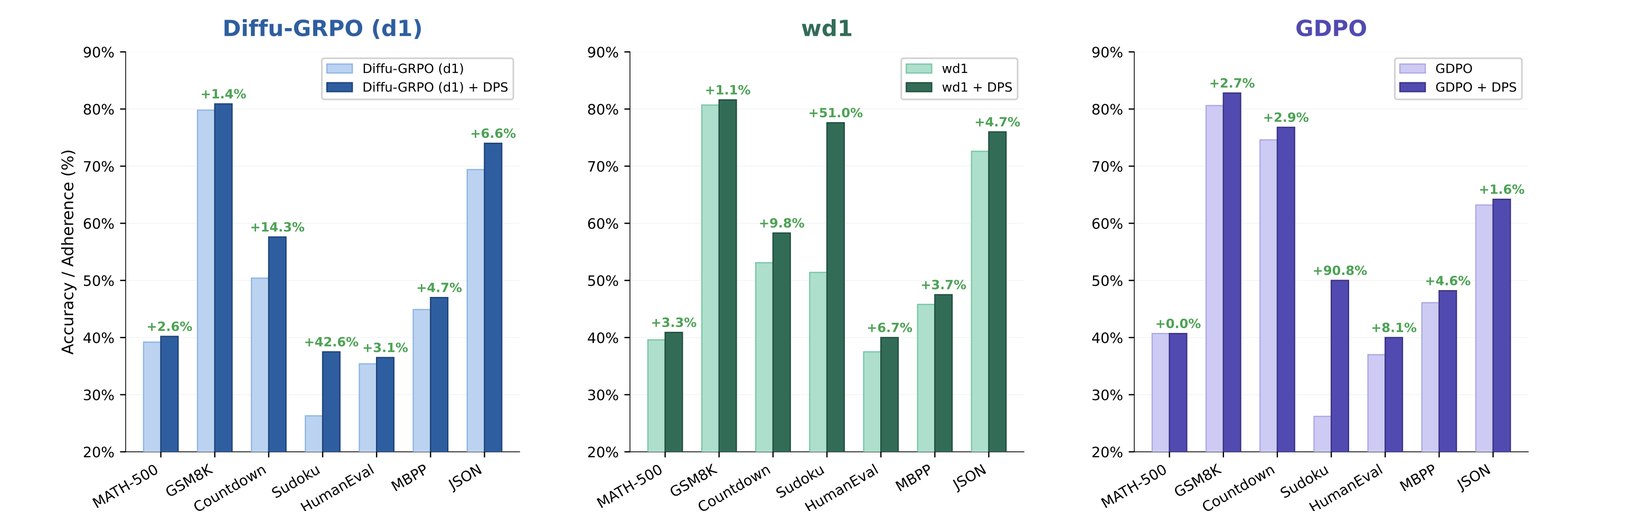
Existing RL methods for diffusion language models treat every denoising step as equally important and rely on biased, high-variance likelihood estimates. DACA-GRPO adds Denoising Progress Scores, which extract per-token importance weights from intermediate predictions at no extra forward cost, and Stratified Masking Likelihood, which reduces mean-field bias. Applied on top of three GRPO base methods, it improves results across seven benchmarks spanning mathematical reasoning, code generation, constraint satisfaction and constrained generation.